Kuľtura Käännös 8. marraskuuta 2026
Neljäkymmentä vuotta ersän kielen parissa
Käännös artikkelista: ersäksi · venäjäksi
Suomentanut Erźań Mastorin toimitus · Kielentarkistus A.A.
Jack Rueterin arvion mukaan kone oppii tunnistamaan ersänkielistä puhetta, kun äänitteitä on 20–50 tuntia. Mozilla Common Voicessa niitä on 3,9 tuntia kolmeltatoista puhujalta.
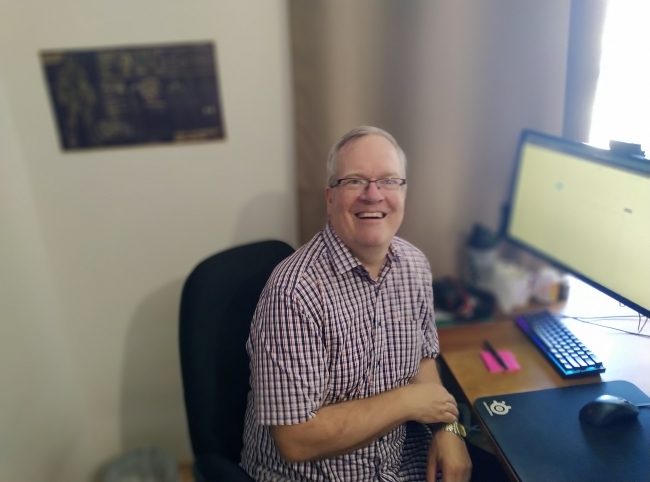
Keväällä 1988 eräs Helsingin yliopiston opiskelija teki sivutöikseen tallennustyötä: hän syötti Macintoshille Heikki Paasosen ersän, mokšan ja šokšan murteiden sanakortteja – suoraan käsinkirjoitetuilta lehdiltä, monien toimittajanmerkintäkerrosten läpi. Myöhemmin hän opetti suomea Saranskin yliopistossa.
Nykyään Jack Rueter on tutkimusinfrastruktuurin insinööri Helsingin yliopiston digitaalisten ihmistieteiden osastolla – osastolla, joka ylläpitää Kielipankkia. Hänen työnsä tulosta ovat ersän morfologinen jäsennin, ersän puupankki kansainvälisessä Universal Dependencies -hankkeessa, sanakirjat, korpukset ja ersän näppäimistöasettelu.
”Kieli oli ehdottomasti elossa, ja ihmiset ehdottomasti elivät siinä”
Ensimmäiset suomen sanasi sanoit seitsemäntoistavuotiaana. Miten ersästä tuli sinun kielesi? Oliko jokin teksti, äänite tai ihminen, jonka jälkeen jäit aiheen pariin?
Itse asiassa tulin uralilaisten kielten pariin aikaisemmin kuin moni luulee. Uralilaisiin tutkimuksiin tulin Helsingin yliopistossa 1980-luvun puolivälissä, kun minulle näytettiin suomen sukukieliä: pohjoissaamea, unkaria, viroa.
Ersää aloin puhua vuonna 1992. Samana vuonna matkustin ensimmäistä kertaa Mordvaan ja osallistuin Mordvan valtionyliopiston murreopintomatkalle ersäläisiin kyliin Tšuvassian Atratin lähelle. Elävä kieli, jota puhutaan kotona ja kylissä, eivätkä vain vanhukset vaan kaikki, jopa opiskelijat, joiden kanssa tulin – se muutti täysin käsitykseni. Opiskelijan kiinnostuksesta tuli elinikäinen side.
Ersän rakenteessa minut valloitti se, että se menee pidemmälle kuin suomen ja skandinaavisten kielten morfologian yhdistelmä, ja tekee sen poikkeuksellisen tyylikkäästi. Voi sanoa yhden sanan, kudo-so-nzo-ĺ-iń, ja se kantaa kokonaisen lauseen merkityksen: ”olin hänen talossaan”. Mutta ennen kaikkea – kohtaamiset kylien ersäläisten kanssa Mordvassa ja sen ulkopuolella, ihmisten, jotka pitivät perintöään ja äidinkieltään tavallisina, arkisina asioina. Kieli oli ehdottomasti elossa, ja ihmiset ehdottomasti elivät siinä.
Pokémonit ja se, mitä puuttuu
Mistä saadaan aineistoa kielelle, jota internetissä tuskin on? Olet kirjoittanut siitä, miten uhanalaisten kielten jäsentimiä rikastettiin pokémonien nimillä – se kuulostaa vitsiltä, kunnes miettii, miksi sitä tarvittiin. Mitä teiltä yhä puuttuu? Ja mitkä jo olemassa olevat ersänkieliset tekstit – aikakauslehdet, kirkolliset kirjat, oppikirjat – voisi muuttaa käyttökelpoiseksi resurssiksi, ja kenen työ se on?
Kun vähäresurssiselle kielelle rakennetaan kieliteknologian työkaluja, tekstiä on koottava kaikista saatavilla olevista suunnista: historialliset kieliopit – Gabelentz, Wiedemann, Paasonen; 1800-luvun käännöskirjallisuus; kansanperinnekokoelmat; neuvostoajan aikakauslehdet – Śatko, historiallinen Erźań Mastor; nykyinen kaunokirjallisuus ja nykyiset verkkotekstit. Tosin verkkoteksti tarkoittaa yleensä sitä, ettei sitä ole lukenut yksikään toimittaja.
Pokémonien mainitseminen viittaa soveltavan laskennallisen kielitieteen tärkeään sääntöön: ihmiset puhuvat kielellään nykyelämästä. Jos puhuja kirjoittaa vaikkapa lauseen ”Pikachu on lempihahmoni” tai mainitsee nykyisiä tavaramerkkejä, teknisiä sanoja ja populaarikulttuurin ilmiöitä oikolukuohjelmassa tai konekäännöksessä, ja järjestelmä merkitsee jokaisen erisnimen virheeksi tai kaatuu kokonaan, sen kanssa on mahdoton työskennellä. Kun rikastamme morfologisia jäsentimiä kansainvälisillä erisnimillä, tuotemerkkien nimillä ja erisnimien taivutusparadigmoilla, varmistamme, että digitaaliset työkalut hyväksyvät luontevan nykykirjoituksen eivätkä pidä maailmanlaajuista sanastoa turmeltuneena kielenä.
Mitä meiltä yhä puuttuu: suuria määriä valmistelematonta nykyistä puhuttua kieltä, avoimesti lisensoitua teknistä asiaproosaa ja toisiinsa kohdistettuja ääni- ja tekstikorpuksia. Mutta voi sanoa toisinkin: ersäläiset ovat käytännöllisiä ihmisiä, ja hyvin harva näkee vaivaa ilmaiseksi. Jotkut näyttävät ajattelevan, että tämä on niiden tehtävä, joille maksetaan siitä, että he ovat ersäläisiä. Opettajat voisivat yrittää sisällyttää tällaisen keruun työhönsä, mutta ihmisiä, jotka olisivat valmiita tekemään sitä harrastuksena, on yksinkertaisesti vähän, joten panostaville tarvitaan jonkinlainen palkkio.
Ensimmäiseksi kannattaa digitoida Śatkon ja Surań toltin vuosikerrat, 1900-luvun koulukirjat sekä kansanperinnearkistot Saranskissa, Helsingissä ja Tartossa. Kustantamojen ja kirjoittajien pitää antaa oma panoksensa.
Jos tehdään yhteenveto tänään – mitä digitaalisia resursseja ersälle todella on olemassa ja mitä niistä tavallinen puhuja eikä tutkija voi käyttää?
Tässä on hyödyllistä erottaa toisistaan se, mikä on konepellin alla – mallien ja laskennallisen tutkimuksen tarpeisiin rakennettu infrastruktuuri – ja puhujalle suunnatut työkalut, joita käytetään arkielämässä.
Ersänkielinen Wikipedia on kasvava alusta, jonka pitäisi antaa sekä tavalliselle lukijalle että kieliteknologian kehittäjille kipeästi tarvittavaa avointa aineistoa. Hanke on vielä pieni, ja se hyötyisi taitavista puhujista, jotka suhtautuisivat siihen paikkana, jossa ersänkielistä yhteistä tietoa säilytetään ja laajennetaan. Siihen voi osallistua kuka tahansa. Nyt näitä aineistoja on vaikea käyttää kieliteknologiassa: kielen oikeinkirjoituksen perustasta ei ole yksimielisyyttä. Siellä on sekä kyrillisiä, vakiintuneen oikeinkirjoituksen mukaisia, että latinalaisia artikkeleita, jotka on linkitetty toisiinsa, sen sijaan että olisi yksinkertainen muunnin kyrillisen ja latinalaisen kirjoituksen välillä. Ja on näppäimistöasetteluja. Ne voi asentaa Google Playsta – sovellukset Divvun-keyboard ja Divvun-dev-keyboard. Macille ja Windowsille ersä on saatavilla myös, Divvun Managerin kautta.
Ersälle ei ole puhesynteesiä eikä puheentunnistusta, emmekä löytäneet ersän näppäimistöasettelua GiellaLT:stä, vaikka komille sellainen on. Mitä tarvitaan, jotta tämä muuttuisi – rahaa, aineistoa, ihmisiä? Konkreettisesti: kuinka monta tuntia äänitettyä puhetta, millaista laatua ja kenen se pitäisi äänittää?
Teidän kannattaa ilmeisesti katsoa Divvun Managerin, Google Playn ja App Storen latauksia – niistä on kerrottu edellä.
Kielipankin rinnakkaiskorpuksiin kuuluva ”Jouluevankeliumin” demo osoittaa, että puhesynteesin parissa voidaan työskennellä ja luultavasti työskennelläänkin. Ongelma on siinä, että näytteitä, joiden pohjalta ääntä voi rakentaa, on vähän, ja siksi puhe ei ole samanlaista kuin koulutetulla radio- tai televisiokuuluttajalla.
Puhesynteesi ja puheentunnistus eivät ole enää kaukainen unelma. Olin mukana tuomassa Mozilla Common Voiceen ersän ja mokšan – se on avoin alusta, jolla tarvittavia puheaineistoja nimenomaan kerätään. Joskus riittää pieni mutta kunnianhimoinen opiskelijaryhmä. Ehkä he tekisivät sen kesäprojektina.
Mitä puheteknologia tarvitsee
- Puheentunnistus (ASR). Aineiston määrä: 20–50 tuntia äänitteitä ja tarkat lauselitteroinnit. Laatu: erilaisia ääniä – miesten ja naisten, nuorten ja vanhojen; äänitys hiljaisessa huoneessa Mozilla Common Voicen kautta. Kuka äänittää: puhujat, jotka lukevat Common Voicessa uutisia, kertomuksia tai kehotteita.
- Puhesynteesi (TTS). Aineiston määrä: 3–5 tuntia puhdasta studioäänitystä samasta äänestä. Laatu: hyvä mikrofoni, hiljainen huone, tasainen tempo ja intonaatio. Kuka äänittää: selkeä-ääninen puhuja – radiojuontaja, opettaja, näyttelijä.
Kuka tahansa voi osallistua heti. Osallistuminen ersän Mozilla Common Voiceen rakentaa suoraan juuri sitä aineistoa, jota tarvitaan, jotta ersälle syntyisivät ensimmäiset puheentunnistusmallit.
Missä ersä on sukukielten joukossa
Olet rakentanut työkaluja myös komille, udmurtille, koltansaamelle ja liiville. Missä ersä on niiden joukossa tänään? Ja siellä, missä jokin toinen uralilainen kieli on edennyt pidemmälle, mitä tarkalleen tehtiin toisin? Kuinka paljon kyse on puhujista itsestään ja kuinka paljon rahasta ja instituutioista?
Pohjoissaame ja koltansaame nojaavat lakiin kirjattuihin kielellisiin oikeuksiin, saamelaiskäräjiin ja Tromssassa toimivaan omaan Divvun-tiimiin. Niille on tehty sisäänrakennetut oikolukuohjelmat, puhesynteesi ja puheentunnistus sekä tuki suoraan käyttöjärjestelmässä.
Ersä, komi ja udmurtti sijoittuvat vankasti keskitasolle. GiellaLT-ekosysteemissä, johon olen panostanut vuodesta 2004, ersällä on ensiluokkaiset morfosyntaktiset jäsentimet, Universal Dependencies -puupankki ja aineistonkeruu Mozilla Common Voicessa. Liiviä tukevat sekä valtion rahoitus että hyvin järjestäytynyt kiinnostuneiden ihmisten ryhmä.
Mikä teki eron? Ensinnäkin institutionaalinen tuki: korvamerkitty valtion rahoitus, kuten Divvunilla Norjassa, mahdollistaa vakituiset insinöörit, jotka ylläpitävät infrastruktuuria jokaisen käyttöjärjestelmäpäivityksen yhteydessä.
Toiseksi yhteisötyö. Pelkkä raha ei riitä. Tarvitaan eläviä puhujayhteisöjä, jotka äänittävät kehotteita, testaavat työkaluja ja kirjoittavat kielellään digitaalisesti. Ersällä on intohimoisia puhujia, mutta ei hyvin toimivaa työryhmää, joka tarttuisi asiaan ja veisi sitä omin käsin eteenpäin. Sen sijaan tarvitaan ihmisiä, jotka ymmärtävät, että kielitieteilijät ovat samanlaisia ammattilaisia kuin hammaslääkärit.
Julkaisit hiljattain tutkimuksen ersän ja mokšan murrekartoituksesta. Kuinka suurta murrevaihtelu on ja mitä digitaaliset työkalut sille tekevät: säilyttävätkö ne murteita vai pakottavatko kielen yhteen normiin?
Käsitykseni mordvalaisista murteista alkoi vasta keväällä 1988 Paasosen sanakirjasta, eikä se ole vieläkään läheskään täydellinen, mutta se on opettanut minut pyrkimään kuvailuun eikä normittamiseen. Niko Partasen kanssa tekemämme tuore tutkimus ersän ja mokšan murrekartoituksesta osoittaa, että Volgan valuma-alueen asutusten halki ulottuvissa murreketjuissa on poikkeuksellisen suuri osa, joka vaatii lisätutkimusta. Työtä on siis vielä paljon, ennen kuin todella ymmärrämme, kuinka läheisesti nämä kaksi kielimuotoa liittyvät toisiinsa.
On olemassa myytti, että digitaaliset työkalut väistämättä pakottavat kielen jäykkään kirjakielen normiin ja pyyhkivät pois paikalliset murteet. Se riippuu tietenkin toimittajista, oikolukijoista ja kirjoittajista. GiellaLT:n äärellisten tilojen malleissani yritän kulkea pohjoissaamen tietä – rakentaa malleja, jotka sallivat useita normeja ja tuntevat murteet.
Olet digitoinut ersänkielisen Uuden testamentin vuosilta 1821–1827 ja Gabelentzin kieliopin. Mitä kaksisataa vuotta vanha teksti antaa elävälle kielelle tänään – onko se museoesine vai työmateriaali?
Gabelentzin kieliopissa kiinnostavaa on tämä: hän näyttää käsitelleen poikkeuksellisen perusteellisesti kielen ilmiöitä, jotka on yhä tänä päivänä tutkittu puutteellisesti. Hän pystyi näkemään tekstissä merkkejä siitä, ettei teksti voinut olla yhden ihmisen kirjoittama.
Se on ehdottomasti työmateriaalia eikä museoesineitä. Ersänkielinen Uusi testamentti ja Gabelentzin kielioppi ”Versuch einer Mordwinischen Grammatik” tallensivat ersää ennen 1900-luvun standardointia ja ennen voimakkaita nykyaikaisia lainoja. Ne antavat aitoja omaperäisiä sanojenmuodostustapoja, jotka auttaisivat tänäänkin ymmärtämään murteita ja ehkä myös löytämään, miten šokša asettuu mordvalaiseen solmuun. Ja vanhojen lähteiden digitointi tuottaa diakronisia korpuksia: kaksi vuosisataa kieliopillista kehitystä avoimesti saatavilla Zenodossa ja GitHubissa.
Kuka tänään ylläpitää ersän resursseja ja mitä niille tapahtuu, jos nämä ihmiset lopettavat?
Pitkäikäisyys vaatii yksittäisten ylläpitäjien ulkopuolelle siirtymistä – kestäviin avoimen tieteen rakenteisiin. Tänään resurssit elävät GitHubin repositorioissa: siellä on puupankkien, äärellisten tilojen mallien, konekäännöksen ja korpusten koodi. Ne elävät GiellaLT-infrastruktuurissa Norjan arktisen yliopiston palvelimilla. Mozilla Common Voicessa. Kielipankissa ja CLARINissa. Ja Zenodossa – avoimessa, pysyvät tunnisteet antavassa säilytyspalvelussa, jota ylläpitää CERN.
Kaikki koodi ja kaikki aineisto on julkaistu avoimilla lisensseillä. Kenellä tahansa on laillinen oikeus ottaa ne, sijoittaa ne omalle palvelimelleen ja päivittää niitä. Yhtäkään resurssia ei ole lukittu yksityisen maksumuurin taakse.
Odotan aikaa, jolloin voin avoimesti, instituutioiden kautta, työskennellä yhdessä kollegojen kanssa Mordvassa ja sen ympäristössä. Toivon kovasti, että työstä, jota olen tehnyt lähes neljäkymmentä vuotta, palautuisi jotain niille ihmisille, jotka silloin innoittivat minua.
”Teknologia on vain tyhjä tynnyri”
Oletetaan, että ersäläinen haluaa auttaa, mutta hän ei ole ohjelmoija eikä kielitieteilijä – opettaja, kuljettaja, mummo, joka puhuu kieltä kotona. Onko jotain, mitä tällainen ihminen voi tehdä ja millä on todella merkitystä?
Kyllä – ehdottomasti, aivan varmasti.
Teknologia on vain tyhjä tynnyri. Veri, joka sen täyttää, ovat kielen puhujat. Joten tynnyriä me tarvitsemme, mutta vielä enemmän tarvitsemme teitä, koska juuri te voitte antaa sen panoksen, joka ratkaisee kaiken.
Ensimmäinen. Äänittäkää ja tarkistakaa puhetta Mozilla Common Voicessa. Siellä voi lukea ääneen lyhyitä ersänkielisiä lauseita tai kuunnella ja tarkistaa muiden äänitteitä.
Toinen. Oikolukekaa digitoituja tekstejä ja kaikkien löytämienne julkaisujen vuosikertoja. Kouluissa ja kirjastoissa voi olla kokonainen aarre, jota ei ole vielä digitoitu; jakakaa niille se, mitä teillä on – silloin niistäkin tulee vaalijoita. Kun vanhoja kirjoja tai vuosikertoja skannataan, kone tekee kirjoitusvirheitä. Ajatus, että puhuja vertaa tunnistettua tekstiä skannaukseen, korjaa ne ja muuttaa raa’at skannaukset puhtaaksi kieliaineistoksi, on kaunis satu. Mutta jos tämä työ annetaan nuorille, sen voi esittää tilaisuutena näyttää kykynsä: he tarvitsevat tunnustusta.
Kolmas. Kirjoittakaa ersäksi sosiaalisessa mediassa ja Wikipediassa. Algoritmit oppivat siitä, mitä verkossa on. Jokainen merkintä, jokainen julkaisu, jokainen ersänkielinen artikkeli laajentaa kielen digitaalista jalanjälkeä.
Neljäs. Jakakaa murresanoja, sananlaskuja ja perheen tarinoita – lapsille ja lapsenlapsille, ilman erityistä syytä. Antakaa ersän kielelle työtä. Mummoilla ja vanhemmilla puhujilla on sanoja, joita sanakirjat eivät ole saaneet kiinni: paikallisten kasvien nimiä, säähän liittyviä sanoja, sananparsia. Kirjaamalla ne muistiin säilytämme sen, mitä ei voi korvata millään.
Viides. Asentakaa ersän näppäimistöasettelut ja käyttäkää niitä joka päivä, kotona ja koulussa. Kirjoittakaa lapsille ja ystäville ersäksi. Kertokaa kehittäjille, mikä teitä haittaa, mitä puuttuu ja mikä onnistui.
Puhu ersää – ja ajattelusi vahvistuu. Ja ASR paranee. Uudet algoritmit keräävät ja oppivat siitä, mitä jonnekin kertyy.
Ersän digitaalinen selviytyminen ei kuulu vain yliopistojen laboratorioille Helsingissä tai Saranskissa. Se kuuluu jokaiselle puhujalle, joka tänään valitsee puhua, kirjoittaa, lukea ja tallentaa kieltään.
Mitä ersälle on jo tänään
- Näppäimistö. Divvun Keyboards -sovellus Google Playssa ja App Storessa – siinä on ersän näppäimistöasettelu. Windowsille ja Macille – Divvun Manager -ohjelma, borealium.org/nb/resource/divvun-manager/. Asettelussa on vanhojen tekstien merkit: ѣ, ҥ, џ, ѕ, ѵ, ѷ, є, ӓ, ў. Asettelu on kyrillinen; ersän latinalaiselle kirjoitukselle Divvunilla ei ole asettelua.
- Latinalainen asettelu. Oma asettelumme ersän latinalaiselle kirjoitukselle: valks.erzja.info/ru/raskladki – Windowsille, macOS:lle ja Linuxille; puhelimissa (Android ja iOS) se toimii ilmaisen Keyman-sovelluksen kautta.
- Oikoluku. Androidin asettelussa se on sisäänrakennettu, mutta vielä keskeneräinen. Verkossa – divvun.uit.no, kieliluettelossa ”Эрзянь кель”; versio on toistaiseksi kehittäjille.
- Äänitä oma äänesi. commonvoice.mozilla.org/myv/speak – lue lauseita ääneen; commonvoice.mozilla.org/myv/listen – tarkista muiden äänitteitä. 8. marraskuuta 2026 ersänkielistä puhetta oli äänitetty 3,9 tuntia kolmeltatoista puhujalta, tarkistettu 3,8 tuntia, ja luettavaksi oli valmisteltu 5 015 lausetta.
- Sanakirjat. Venäjä–ersä-sanakirjamme Valks: valks.erzja.info – 8. marraskuuta 2026 siinä on 25 057 sana-artikkelia, joista 15 301 on tiimimme ylläpitämää nykysanakirjaa ja 9 756 Heikki Paasosen sanakirjan digitoitua murrekerrosta. Puhujat ovat äänittäneet 10 196 sanaa. Korteilla on 521 puhujien tarkistamaa esimerkkiä ja yli 16 000 esimerkkiä Paasosen sanakirjasta. Haku tunnistaa 10 439 sanan taivutusmuodot: yhteensä noin 254 000 muotoa, jotka morfologinen jäsennin tuottaa. Lisäksi on 125 fraasin keskusteluopas, 24 oppitunnin itseopiskelukurssi, 207 julkaisun kirjasto ja käyttöliittymä venäjäksi, englanniksi ja saksaksi.
- GiellaLT-hankkeen Valks-sanakirja, joka jäsentää minkä tahansa sanamuodon: valks.oahpa.no – Neahttadigisánit-alusta, ersä yhdessä venäjän, englannin, saksan, suomen, viron, ranskan ja mokšan kanssa.
- Sanakirjojen muokkausalusta: akusanat.com/verdd – Verdd, Rueterin oma alusta; siinä on 56 kieltä, ersä koodilla myv.
- Korpukset. Kielipankki: kielipankki.fi/korp/. Ersän korpukset: erzya.web-corpora.net – pääkorpus (2,3 miljoonaa sanaa: lehdistö, proosa, blogit) ja sosiaalisen median korpus (830 000 sanaa); tekstit heinäkuuhun 2018 asti.
- Digitoidut kirjat. Kansalliskirjaston Fenno-Ugrica-kokoelma: fennougrica.kansalliskirjasto.fi – digitoituja kirjoja, myös 1930- ja 1940-luvuilta.
- Ersänkielinen Wikipedia: myv.wikipedia.org. 8. marraskuuta 2026 siinä oli 7 878 artikkelia ja 15 aktiivista osallistujaa viimeisen kuukauden aikana.