Культура интервью 8 ноября 2026 · 13 мин чтения
Сорок лет с эрзянским языком
По оценке Джека Рютера, чтобы машина научилась разбирать эрзянскую речь, нужно от двадцати до пятидесяти часов записей. На Mozilla Common Voice их 3,9 часа, от тринадцати человек.
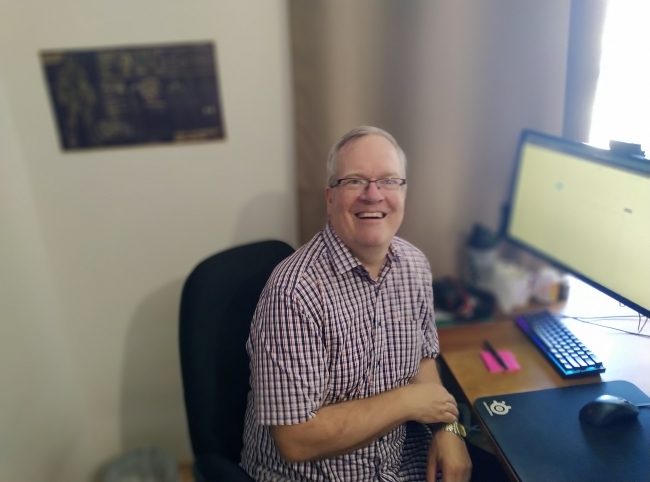
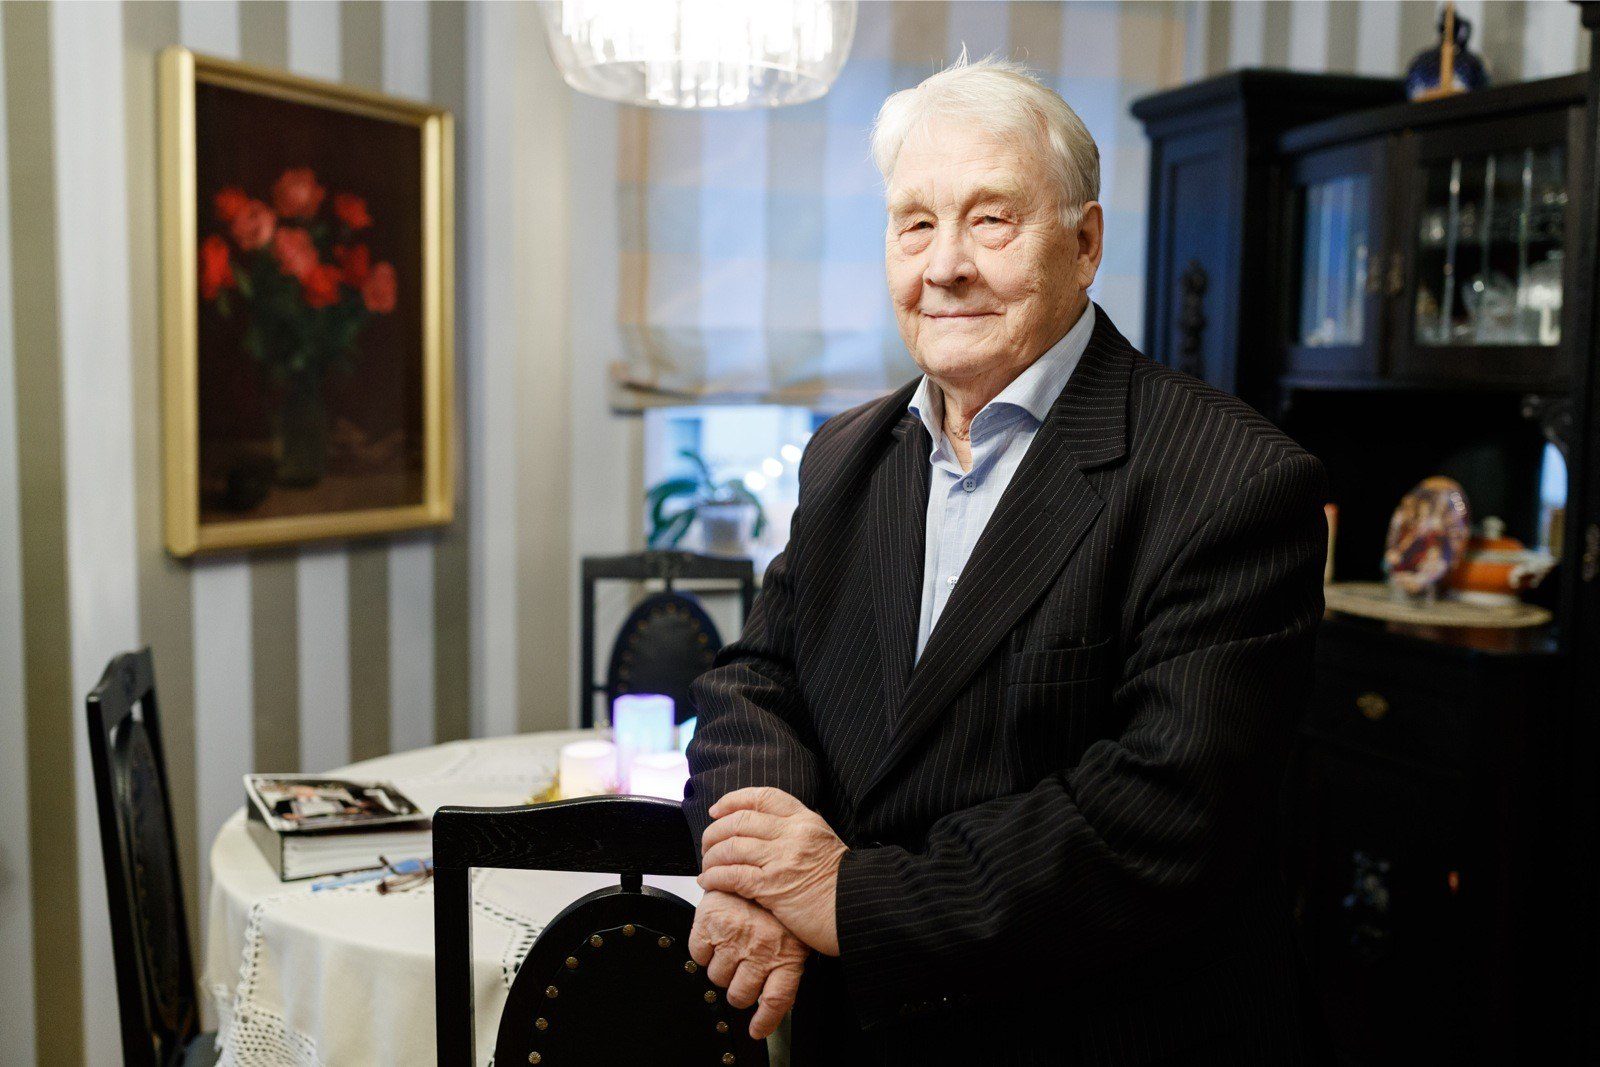
Весной 1988 года студент Хельсинкского университета подрабатывал набором: вводил в «Макинтош» эрзянские, мокшанские и шокшанские диалектные карточки Хейкки Паасонена — прямо с рукописных листов, сквозь многие слои редакторских помет. Позже он преподавал финский в университете в Саранске.
Сегодня Джек Рютер — инженер исследовательской инфраструктуры на кафедре цифровых гуманитарных наук Хельсинкского университета. Кафедры, которая ведёт Языковой банк Финляндии. Его работой сделаны морфологический анализатор эрзянского, эрзянский трибанк в международном проекте Universal Dependencies, словари, корпуса и эрзянская клавиатурная раскладка.
«Язык был безусловно жив, и в нём безусловно жили люди»
Первые финские слова вы сказали в семнадцать лет. Как эрзянский стал вашим? Был ли текст, запись или человек, после которых вы остались в теме?
На самом деле к уральским языкам я пришёл раньше, чем многие думают. В уральские исследования я вошёл в Хельсинкском университете в середине восьмидесятых, когда мне показали родственные финскому языки: северносаамский, венгерский, эстонский.
Говорить по-эрзянски я начал в 1992 году. В тот же год я впервые поехал в Мордовию и участвовал в учебной диалектологической поездке Мордовского государственного университета в эрзянские сёла под Атрать в Чувашии. Живой язык, на котором говорят дома и в сёлах, и не только старики, а все, даже студенты, с которыми я приехал, — это полностью изменило моё понимание. Студенческий интерес превратился в связь на всю жизнь.
Что захватило меня в эрзянском по устройству — он идёт дальше, чем сочетание финской и скандинавской морфологии, и делает это необычайно изящно. Можно сказать одно слово, kudo-so-nzo-ĺ-iń, и оно несёт значение целого предложения: «я был в его или её доме». Но прежде всего — встречи с эрзянами из сёл, в Мордовии и за её пределами, которые принимали своё наследие и родной язык как обычные, повседневные вещи. Язык был безусловно жив, и в нём безусловно жили люди.
Покемоны и чего не хватает
Откуда берутся данные для языка, которого в интернете почти нет? Вы писали о том, как обогащали анализаторы языков под угрозой именами покемонов, — это звучит шуткой, пока не подумаешь, зачем это понадобилось. Чего вам до сих пор не хватает? И какие уже существующие эрзянские тексты — периодику, церковные книги, учебники — можно было бы превратить в рабочий ресурс, и чья это работа?
Чтобы строить языковые инструменты для малоресурсного языка, текст приходится собирать со всех доступных сторон: исторические грамматики — Габеленц, Видеман, Паасонен; переводная литература девятнадцатого века; фольклорные собрания; периодика советского времени — «Сятко», историческая «Эрзянь Мастор»; современная художественная литература и нынешние сетевые тексты. Правда, сетевой текст обычно значит, что его не смотрел редактор.
Упоминание покемонов указывает на важное правило прикладной вычислительной лингвистики: люди говорят на языке о современной жизни. Если носитель набирает фразу вроде «Пикачу — мой любимый персонаж» или упоминает современные торговые марки, технические слова и явления поп-культуры в проверке орфографии или в машинном переводе, а система помечает каждое имя собственное как ошибку или вовсе падает, работать с ней невозможно. Обогащая морфологические анализаторы международными именами собственными, названиями марок и парадигмами имён собственных, мы добиваемся того, чтобы цифровые инструменты принимали естественное современное письмо и не считали мировую лексику испорченным языком.
Чего нам до сих пор не хватает: больших объёмов неподготовленной современной разговорной речи, технической прозы под открытой лицензией и выровненных параллельных корпусов «звук — текст». Но можно сказать и иначе: эрзяне люди практичные, и очень немногие станут утруждать себя работой задаром. Похоже, кое-кто считает, что делать это должны те, кому платят за то, что они эрзяне. Учителя могли бы попробовать встроить такой сбор в свою работу, но людей, готовых заниматься этим как увлечением, попросту мало, так что нужно какое-то вознаграждение для тех, кто вкладывается.
Оцифровывать в первую очередь стоит подшивки «Сятко» и «Сурань толт», школьные учебники двадцатого века, фольклорные архивы в Саранске, Хельсинки и Тарту. Свой вклад должны вносить издательства и авторы.
Если подвести итог сегодня — какие цифровые ресурсы для эрзянского действительно существуют и какими из них может пользоваться обычный носитель, а не исследователь?
Тут помогает различать то, что лежит под капотом, — инфраструктуру, построенную для моделей и вычислительных исследований, — и инструменты, обращённые к говорящему, те, которыми пользуются в обычной жизни.
Эрзянская Википедия — растущая площадка, которая должна давать и обычному читателю, и разработчикам языковых технологий остро нужные открытые материалы. Этот проект пока мал, и ему пошли бы на пользу грамотные носители, которые отнеслись бы к нему как к месту, где хранят и расширяют общее знание на эрзянском языке. Участвовать там может каждый. Сейчас эти материалы трудно использовать в языковых технологиях: нет согласия об орфографической основе языка. Там и кириллические, по стандартной орфографии, и латинские статьи, связанные между собой, вместо того чтобы иметь простой преобразователь между кириллическим и латинским письмом. И есть клавиатурные раскладки. Их можно поставить из Google Play — приложения Divvun-keyboard и Divvun-dev-keyboard. Для Mac и Windows эрзянский тоже доступен, через Divvun Manager.
У эрзянского нет ни синтеза речи, ни распознавания, и эрзянскую клавиатурную раскладку в GiellaLT мы не нашли, хотя для коми она есть. Что нужно, чтобы это изменилось, — деньги, данные, люди? Конкретно: сколько часов записанной речи, какого качества и кто должен их записать?
Вам, судя по всему, стоит посмотреть загрузки Divvun Manager, Google Play и App Store — о них сказано выше.
Демонстрация «Рождественского Евангелия» среди параллельных корпусов в Языковом банке Финляндии показывает, что с синтезом речи люди работать могут и, вероятно, работают. Беда в том, что образцов, по которым можно строить голос, мало, и потому речь получается не такая, как у обученного диктора радио или телевидения.
Синтез и распознавание речи больше не далёкая мечта. Я участвовал в том, чтобы привести на Mozilla Common Voice эрзянский и мокшанский, — это открытая площадка, на которой и собирают нужные речевые наборы. Иногда достаточно небольшой, но честолюбивой группы студентов. Может быть, они сделали бы это летним проектом.
Что нужно для речевых технологий
Вложиться может кто угодно прямо сейчас. Участие в Mozilla Common Voice для эрзянского прямо строит тот набор данных, который нужен, чтобы у эрзянского появились первые модели распознавания речи.
Где эрзянский среди родственных языков
Вы строили инструменты и для коми, удмуртского, колтта-саамского, ливского. Где эрзянский стоит среди них сегодня? И там, где другой уральский язык ушёл дальше, что именно было сделано иначе? Насколько дело в самих носителях, а насколько в деньгах и учреждениях?
Северносаамский и колтта-саамский опираются на закреплённые законом языковые права, на Саамский парламент и на отдельную команду Divvun в Тромсё. У них сделаны встроенные проверки орфографии, синтез и распознавание речи, поддержка прямо в операционной системе.
Эрзянский, коми и удмуртский держат крепкую середину. В экосистеме GiellaLT, куда я вкладываюсь с 2004 года, у эрзянского первоклассные морфосинтаксические анализаторы, трибанк Universal Dependencies и сбор на Mozilla Common Voice. Ливский поддержан и государственным финансированием, и хорошо устроенной группой заинтересованных людей.
Что дало разницу? Во-первых, институциональная опора: выделенное государственное финансирование, как у Divvun в Норвегии, позволяет держать штатных инженеров, которые поддерживают инфраструктуру при каждом обновлении операционных систем.
Во-вторых, общественная работа. Одних денег мало. Нужны живые сообщества носителей, которые записывают подсказки, проверяют инструменты и пишут на своём языке в цифре. У эрзянского есть страстные носители, но нет слаженной рабочей группы, которая взялась бы за дело и двигала его руками. Вместо этого нужны люди, которые понимают, что лингвисты — такие же профессионалы, как зубные врачи.
Недавно вы опубликовали работу по диалектной картографии эрзянского и мокшанского. Насколько велико диалектное варьирование и что с ним делают цифровые инструменты: удерживают диалекты или сводят язык к единой норме?
Моё понимание мордовских диалектов началось только весной 1988 года, со словаря Паасонена, и до сих пор оно далеко не полное, но оно научило меня стремиться к описанию, а не к предписанию. Наше недавнее исследование диалектной картографии эрзянского и мокшанского вместе с Нико Партаненом показывает, что в диалектных цепях, протянувшихся по поселениям Волжского бассейна, остаётся необычайно большая часть, которая требует дальнейшего изучения. Так что работы ещё много, прежде чем мы по-настоящему поймём, насколько эти две языковые формы связаны.
Есть миф, будто цифровые инструменты неизбежно загоняют язык в жёсткую литературную норму и стирают местные говоры. Это, конечно, зависит от редакторов, корректоров и пишущих. В своих конечно-автоматных моделях в GiellaLT я стараюсь идти по северносаамскому пути — строить модели, которые держат несколько норм и знают о диалектах.
Вы оцифровали эрзянский Новый Завет 1821–1827 годов и грамматику Габеленца. Что двухсотлетний текст даёт сегодня живому языку — это музейный предмет или рабочий материал?
В грамматике Габеленца любопытно вот что: похоже, он необычайно основательно разобрал языковые явления, которые и сегодня изучены недостаточно. Он сумел увидеть в тексте признаки того, что текст не мог быть написан одним человеком.
Это решительно рабочий материал, а не музейные предметы. Эрзянский Новый Завет и грамматика Габеленца «Versuch einer Mordwinischen Grammatik» записали эрзянский до стандартизации двадцатого века и до сильных современных заимствований. Они дают подлинные родные способы образования слов, которые и сегодня помогли бы понять диалекты, а может быть, и обнаружить, как в мордовский узел встраивается шокшанский. А оцифровка старых источников даёт диахронические корпуса: два века грамматической эволюции, открыто выложенные на Zenodo и GitHub.
Кто сегодня поддерживает эрзянские ресурсы и что с ними станет, если эти люди перестанут?
Долговечность требует выйти за пределы отдельных смотрителей — в устойчивые открытые научные рамки. Сегодня ресурсы живут в репозиториях на GitHub: там код трибанков, конечно-автоматных моделей, машинного перевода и корпусов. Живут в инфраструктуре GiellaLT на серверах Арктического университета Норвегии. На Mozilla Common Voice. В Языковом банке Финляндии и в CLARIN. И на Zenodo — открытом хранилище с постоянными идентификаторами, которое держит CERN (Европейская организация по ядерным исследованиям).
Весь код и все данные выпущены под открытыми лицензиями. У любого есть законное право взять их, разместить у себя и обновлять. Ни один ресурс не заперт за частной платной стеной.
Я жду времени, когда смогу открыто, по институтской линии, работать вместе с коллегами в Мордовии и вокруг неё. Мне очень хочется, чтобы от работы, которой я занимаюсь почти сорок лет, что-то вернулось к людям, которые меня тогда вдохновили.
«Технология — всего лишь пустая бочка»
Допустим, эрзянин хочет помочь, но он не программист и не лингвист — учитель, водитель, бабушка, которая говорит на языке дома. Есть ли что-то, что такой человек может сделать и что действительно будет иметь значение?
Да — безусловно, совершенно определённо.
Технология — всего лишь пустая бочка. Кровь, которая её наполняет, — это носители языка. Так что бочка нам нужна, но ещё больше нужны вы, потому что именно вы можете сделать тот вклад, который всё решает.
Первое. Записывайте и проверяйте речь на Mozilla Common Voice. Там можно прочитать вслух короткие эрзянские предложения или послушать и проверить чужие записи.
Второе. Вычитывайте оцифрованные тексты и подшивки всех изданий, какие найдёте. В школах и библиотеках может лежать целый клад, который ещё не оцифрован; поделитесь тем, что у вас есть, с ними — тогда и они станут хранителями. Когда старые книги или подшивки сканируют, машина делает опечатки. Мысль, что носитель сверит распознанный текст со сканом, поправит их и превратит сырые сканы в чистые языковые данные, — красивая сказка. Но если поручить эту работу молодым, её можно подать как возможность показать себя: им нужно признание.
Третье. Пишите по-эрзянски в социальных сетях и в Википедии. Алгоритмы учатся по тому, что есть в сети. Каждая запись, каждый пост, каждая статья по-эрзянски расширяет цифровой след языка.
Четвёртое. Делитесь диалектными словами, пословицами и семейными историями — с детьми и внуками, без повода. Дайте эрзянскому языку работу. У бабушек и старших носителей есть слова, которых словари не поймали: названия местных растений, слова о погоде, поговорки. Записывая их, мы сохраняем то, чего ничем не заменишь.
Пятое. Ставьте эрзянские раскладки и пользуйтесь ими каждый день, дома и в школе. Пишите детям и друзьям по-эрзянски. Рассказывайте разработчикам, что вам мешает, чего не хватает и что получилось.
Говори по-эрзянски — и твой строй мысли окрепнет. И ASR станет лучше. Новые алгоритмы собирают и учатся тому, что где-то накапливается.
Цифровое выживание эрзянского принадлежит не одним университетским лабораториям в Хельсинки или Саранске. Оно принадлежит каждому говорящему, кто сегодня выбирает говорить, писать, читать и записывать свой язык.