Kuľtura Tõlge 8. november 2026
Nelikümmend aastat ersa keelega
Tõlge artiklist: ersa keeles · vene keeles
Tõlkinud Erźań Mastori toimetus · Keeletoimetanud A.A.
Jack Rueteri hinnangul on selleks, et masin õpiks ersakeelset kõnet ära tundma, vaja kahekümne kuni viiekümne tunni jagu salvestusi. Mozilla Common Voice’is on neid 3,9 tundi, kolmeteistkümnelt inimeselt.
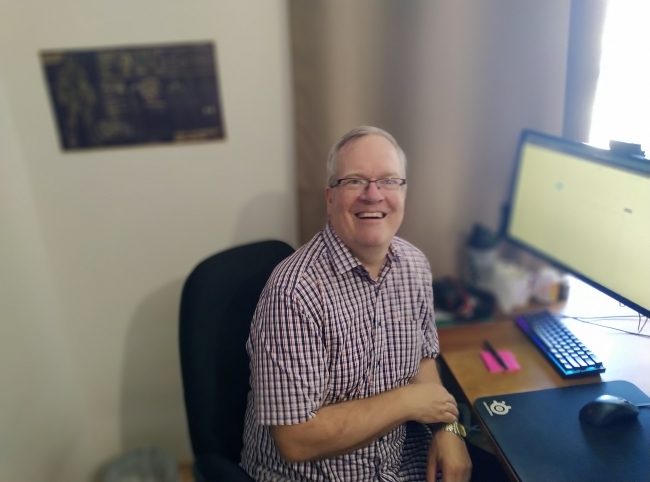
1988. aasta kevadel teenis üks Helsingi Ülikooli üliõpilane lisa trükkimisega: ta sisestas Macintoshi Heikki Paasoneni ersa, mokša ja šokša murdekartoteegi kaarte — otse käsikirjalistelt lehtedelt, läbi toimetajamärkuste paljude kihtide. Hiljem õpetas ta Saranski ülikoolis soome keelt.
Täna on Jack Rueter Helsingi Ülikooli digihumanitaaria osakonna uurimistaristu insener. Selle osakonna, mis haldab Soome Keelepanka. Tema töö tulemusel on valminud ersa keele morfoloogiline analüsaator, ersa puudepank rahvusvahelises projektis Universal Dependencies, sõnaraamatud, korpused ja ersa klaviatuuripaigutus.
„Keel oli kahtlemata elus ja selles elasid kahtlemata inimesed“
Esimesed soomekeelsed sõnad ütlesite seitsmeteistkümneaastaselt. Kuidas sai ersa keel teie omaks? Kas oli mõni tekst, salvestis või inimene, kelle järel te teema juurde jäite?
Tegelikult jõudsin uurali keelte juurde varem, kui paljud arvavad. Uurali uuringutesse sattusin Helsingi Ülikoolis kaheksakümnendate keskel, kui mulle näidati soome keele sugulaskeeli: põhjasaami, ungari ja eesti keelt.
Ersa keelt hakkasin rääkima 1992. aastal. Samal aastal sõitsin esimest korda Mordvasse ja osalesin Mordva Riikliku Ülikooli murdeõppe-ekspeditsioonil ersa küladesse Tšuvaššias Atrati lähedal. Elav keel, mida räägitakse kodus ja külades, ja mitte ainult vanad inimesed, vaid kõik, isegi üliõpilased, kellega ma kohale tulin, — see muutis täielikult minu arusaama. Üliõpilashuvist sai eluaegne side.
Mis mind ersa keele ehituses köitis: see läheb kaugemale kui soome ja skandinaavia morfoloogia kombinatsioon ning teeb seda erakordselt elegantselt. Võib öelda ühe sõna, kudo-so-nzo-ĺ-iń, ja see kannab terve lause tähendust: „ma olin tema majas“. Kuid ennekõike — kohtumised külaersadega Mordvas ja sellest väljaspool, kes võtsid oma pärandit ja emakeelt kui tavalisi, igapäevaseid asju. Keel oli kahtlemata elus ja selles elasid kahtlemata inimesed.
Pokemonid ja see, mis on puudu
Kust tulevad andmed keele jaoks, mida internetis peaaegu ei ole? Olete kirjutanud, kuidas rikastasite ohustatud keelte analüsaatoreid pokemonide nimedega, — see kõlab naljana, kuni ei mõtle, milleks seda vaja oli. Mis teil siiani puudu on? Ja milliseid juba olemasolevaid ersakeelseid tekste — perioodikat, kiriklikke raamatuid, õpikuid — saaks muuta tööressursiks ja kelle töö see on?
Väheste ressurssidega keele jaoks keeletööriistu ehitades tuleb teksti koguda igast võimalikust suunast: ajaloolised grammatikad — Gabelentz, Wiedemann, Paasonen; üheksateistkümnenda sajandi tõlkekirjandus; rahvaluulekogud; nõukogudeaegne perioodika — „Śatko“, ajalooline „Erźań Mastor“; tänapäeva ilukirjandus ja praegused võrgutekstid. Tõsi, võrgutekst tähendab tavaliselt, et toimetaja ei ole seda näinud.
Pokemonide mainimine osutab rakendusliku arvutilingvistika olulisele reeglile: inimesed räägivad oma keeles tänapäeva elust. Kui keelekandja kirjutab õigekirjakontrollis või masintõlkes lause nagu „Pikachu on mu lemmiktegelane“ või mainib tänapäeva kaubamärke, tehnikasõnu ja popkultuuri nähtusi ning süsteem märgib iga pärisnime veaks või jookseb sootuks kokku, on sellega võimatu töötada. Rikastades morfoloogilisi analüsaatoreid rahvusvaheliste pärisnimede, kaubamärkide nimede ja pärisnimede paradigmadega, saavutame selle, et digitööriistad aktsepteerivad loomulikku tänapäevast kirjutamist ega pea maailma sõnavara rikutud keeleks.
Mis meil siiani puudu on: suurel hulgal spontaanset tänapäevast kõnet, avatud litsentsiga tehnilist proosat ja joondatud paralleelkorpusi „heli — tekst“. Kuid võib öelda ka teisiti: ersad on praktilised inimesed ja väga vähesed hakkavad end tasuta tööga vaevama. Näib, et mõned arvavad, et seda peaksid tegema need, kellele makstakse selle eest, et nad on ersad. Õpetajad võiksid proovida sellist kogumist oma töösse põimida, kuid inimesi, kes oleksid valmis sellega hobi korras tegelema, on lihtsalt vähe, nii et panustajatele on vaja mingit tasu.
Esimeses järjekorras tasub digiteerida ajakirjade „Śatko“ ja „Surań tolt“ köited, kahekümnenda sajandi kooliõpikud ning rahvaluulearhiivid Saranskis, Helsingis ja Tartus. Oma panuse peavad andma kirjastused ja autorid.
Kui teha täna kokkuvõte — millised ersa keele digiressursid on tegelikult olemas ja milliseid neist saab kasutada tavaline keelekandja, mitte uurija?
Siin aitab eristada seda, mis on kapoti all, — taristut, mis on ehitatud mudelite ja arvutusuuringute jaoks, — ja kõnelejale suunatud tööriistu, mida kasutatakse igapäevaelus.
Ersakeelne Vikipeedia on kasvav platvorm, mis peaks andma nii tavalugejale kui ka keeletehnoloogia arendajatele hädasti vajalikke avatud materjale. See projekt on veel väike ja sellele tuleksid kasuks kirjaoskajad keelekandjad, kes suhtuksid sellesse kui kohasse, kus hoitakse ja laiendatakse ühist ersakeelset teadmist. Osaleda võib seal igaüks. Praegu on neid materjale keeletehnoloogias raske kasutada: puudub kokkulepe keele õigekirjalise aluse kohta. Seal on nii kirillitsas, standardse õigekirja järgi, kui ka ladina kirjas artikleid, mis on omavahel seotud, selle asemel et oleks lihtne teisendaja kirillitsa ja ladina kirja vahel. Ja on klaviatuuripaigutused. Neid saab paigaldada Google Playst — rakendused Divvun-keyboard ja Divvun-dev-keyboard. Maci ja Windowsi jaoks on ersa keel samuti saadaval, Divvun Manageri kaudu.
Ersa keelel ei ole ei kõnesünteesi ega kõnetuvastust ning ersa klaviatuuripaigutust me GiellaLT-st ei leidnud, kuigi komi keele jaoks see on olemas. Mida on vaja, et see muutuks, — raha, andmeid, inimesi? Konkreetselt: mitu tundi salvestatud kõnet, millise kvaliteediga ja kes peaks need salvestama?
Teil tasub ilmselt vaadata Divvun Manageri, Google Play ja App Store’i allalaadimisi — neist on juttu eespool.
„Jõuluevangeeliumi“ demonstratsioon Soome Keelepanga paralleelkorpuste seas näitab, et kõnesünteesiga suudetakse töötada ja tõenäoliselt ka töötatakse. Häda on selles, et näidiseid, mille järgi häält ehitada, on vähe, ja seepärast ei tule kõne selline nagu koolitatud raadio- või telediktoril.
Kõnesüntees ja kõnetuvastus ei ole enam kauge unistus. Osalesin selles, et tuua ersa ja mokša keel Mozilla Common Voice’i — see on avatud platvorm, kus just vajalikke kõneandmestikke kogutaksegi. Mõnikord piisab väikesest, kuid auahnest üliõpilaste rühmast. Võib-olla teeksid nad sellest suveprojekti.
Mida on vaja kõnetehnoloogia jaoks
- Kõnetuvastus (ASR). Kui palju andmeid: 20–50 tundi salvestust täpsete lausetranskriptsioonidega. Milline kvaliteet: eri hääled — mehed ja naised, noored ja vanad; salvestus vaikses ruumis Mozilla Common Voice’i kaudu. Kes salvestab: keelekandjad, kes loevad Common Voice’is uudiseid, jutte või etteantud lauseid. - Kõnesüntees (TTS). Kui palju andmeid: 3–5 tundi puhast stuudiosalvestust ühe ja sama häälega. Milline kvaliteet: hea mikrofon, vaikne ruum, ühtlane tempo ja intonatsioon. Kes salvestab: selge häälega keelekandja — raadiosaatejuht, õpetaja, näitleja.
Panustada võib igaüks kohe praegu. Osalemine Mozilla Common Voice’is ersa keele jaoks ehitab otse just seda andmestikku, mida on vaja, et ersa keelel tekiksid esimesed kõnetuvastusmudelid.
Kus on ersa keel sugulaskeelte seas
Olete ehitanud tööriistu ka komi, udmurdi, koltasaami ja liivi keele jaoks. Kus on ersa keel nende seas täna? Ja seal, kus mõni teine uurali keel on kaugemale jõudnud, mida täpselt tehti teisiti? Kui palju on asi keelekandjates endis, kui palju rahas ja institutsioonides?
Põhjasaami ja koltasaami keel toetuvad seadusega kinnitatud keeleõigustele, saami parlamendile ja eraldi Divvuni meeskonnale Tromsøs. Neil on tehtud sisseehitatud õigekirjakontroll, kõnesüntees ja kõnetuvastus, tugi otse operatsioonisüsteemis.
Ersa, komi ja udmurdi keel hoiavad tugevat keskmist taset. GiellaLT ökosüsteemis, millesse panustan alates 2004. aastast, on ersa keelel esmaklassilised morfosüntaktilised analüsaatorid, Universal Dependenciesi puudepank ja kogumine Mozilla Common Voice’is. Liivi keelt toetavad nii riiklik rahastus kui ka hästi korraldatud huviliste rühm.
Mis tegi vahe? Esiteks institutsionaalne tugi: eraldatud riiklik rahastus, nagu Divvunil Norras, võimaldab pidada koosseisulisi insenere, kes hoiavad taristut töös iga operatsioonisüsteemi uuendusega.
Teiseks kogukonnatöö. Ainult rahast ei piisa. On vaja elavaid keelekandjate kogukondi, kes salvestavad etteantud lauseid, testivad tööriistu ja kirjutavad oma keeles digiruumis. Ersa keelel on kirglikke kõnelejaid, kuid puudub kooskõlastatud töörühm, mis asja ette võtaks ja seda oma kätega edasi viiks. Selle asemel on vaja inimesi, kes mõistavad, et keeleteadlased on samasugused professionaalid nagu hambaarstid.
Avaldasite hiljuti töö ersa ja mokša murrete kartograafiast. Kui suur on murdevariatsioon ja mida digitööriistad sellega teevad: hoiavad murdeid alles või taandavad keele ühtsele normile?
Minu arusaam mordva murretest sai alguse alles 1988. aasta kevadel, Paasoneni sõnaraamatust, ja see on siiani kaugeltki mitte täielik, kuid see õpetas mind taotlema kirjeldamist, mitte ettekirjutamist. Meie hiljutine uurimus ersa ja mokša murrete kartograafiast, mille tegin koos Niko Partaneniga, näitab, et Volga vesikonna asulaid läbivates murdeahelates on erakordselt suur osa, mis vajab edasist uurimist. Nii et tööd on veel palju, enne kui me tõeliselt mõistame, kui tihedalt need kaks keelekuju on seotud.
On müüt, nagu suruksid digitööriistad keele paratamatult jäika kirjakeelenormi ja kustutaksid kohalikud murrakud. See sõltub muidugi toimetajatest, korrektoritest ja kirjutajatest. Oma lõplike automaatide mudelites GiellaLT-s püüan minna põhjasaami teed — ehitada mudeleid, mis hoiavad mitut normi ja teavad murretest.
Digiteerisite ersakeelse Uue Testamendi aastatest 1821–1827 ja Gabelentzi grammatika. Mida annab kahesaja-aastane tekst täna elavale keelele — kas see on muuseumieksponaat või töömaterjal?
Gabelentzi grammatikas on huvitav see: näib, et ta analüüsis erakordselt põhjalikult keelenähtusi, mis on tänini ebapiisavalt uuritud. Ta suutis näha tekstis tunnuseid, mis näitasid, et teksti ei saanud kirjutada üks inimene.
See on kindlasti töömaterjal, mitte muuseumieksponaadid. Ersakeelne Uus Testament ja Gabelentzi grammatika „Versuch einer Mordwinischen Grammatik“ talletasid ersa keele enne kahekümnenda sajandi standardimist ja enne tugevaid tänapäevaseid laene. Need annavad ehtsaid ersa keelele omaseid sõnamoodustusviise, mis aitaksid ka täna murdeid mõista ja võib-olla avastada, kuidas šokša mordva sõlme sobitub. Vanade allikate digiteerimine annab aga diakroonilised korpused: kaks sajandit grammatilist arengut, avalikult üles pandud Zenodosse ja GitHubi.
Kes täna ersa ressursse ülal peab ja mis neist saab, kui need inimesed lõpetavad?
Ressursside pikaajaliseks säilimiseks tuleb liikuda üksikute hooldajate tööst kestlike avatud teaduse raamistikeni. Täna elavad ressursid GitHubi repositooriumides: seal on puudepankade, lõplike automaatide mudelite, masintõlke ja korpuste kood. Nad elavad GiellaLT taristus Norra Arktilise Ülikooli serverites. Mozilla Common Voice’is. Soome Keelepangas ja CLARIN-is. Ning Zenodos — püsiidentifikaatoritega avatud hoidlas, mida peab CERN.
Kogu kood ja kõik andmed on välja antud avatud litsentside all. Igaühel on seaduslik õigus need võtta, enda juures majutada ja uuendada. Ükski ressurss ei ole lukustatud privaatse tasulise müüri taha.
Ootan aega, mil saan avalikult, instituudi kaudu, töötada koos kolleegidega Mordvas ja selle ümbruses. Ma tahan väga, et tööst, millega olen tegelenud peaaegu nelikümmend aastat, jõuaks midagi tagasi inimesteni, kes mind tollal inspireerisid.
„Tehnoloogia on vaid tühi tünn“
Oletame, et mõni ersa tahab aidata, kuid ta ei ole programmeerija ega keeleteadlane — õpetaja, autojuht, vanaema, kes räägib keelt kodus. Kas on midagi, mida selline inimene saab teha ja millel on tõesti tähtsust?
Jah — kahtlemata, täiesti kindlasti.
Tehnoloogia on vaid tühi tünn. Veri, mis seda täidab, on keelekandjad. Nii et tünni on meil vaja, kuid veelgi enam vajame teid, sest just teie saate anda selle panuse, mis kõik otsustab.
Esiteks. Salvestage ja kontrollige kõnet Mozilla Common Voice’is. Seal saab lugeda ette lühikesi ersakeelseid lauseid või kuulata ja kontrollida teiste salvestusi.
Teiseks. Lugege üle digiteeritud tekste ja kõigi väljaannete köiteid, mida leiate. Koolides ja raamatukogudes võib lebada terve aare, mida pole veel digiteeritud; jagage nendega seda, mis teil on, — siis saavad ka neist hoidjad. Kui vanu raamatuid või köiteid skaneeritakse, teeb masin trükivigu. Mõte, et keelekandja võrdleb tuvastatud teksti skaneeringuga, parandab vead ja muudab toored skaneeringud puhtaks keeleandmeteks, on ilus muinasjutt. Kuid kui anda see töö noortele, saab seda esitada kui võimalust ennast näidata: nad vajavad tunnustust.
Kolmandaks. Kirjutage ersa keeles sotsiaalmeedias ja Vikipeedias. Algoritmid õpivad sellest, mis võrgus on. Iga sissekanne, iga postitus, iga ersakeelne artikkel laiendab keele digitaalset jalajälge.
Neljandaks. Jagage murdesõnu, vanasõnu ja perelugusid — lastega ja lastelastega, ilma erilise põhjuseta. Andke ersa keelele tööd. Vanaemadel ja vanematel keelekandjatel on sõnu, mida sõnaraamatud pole kinni püüdnud: kohalike taimede nimetused, ilmasõnad, kõnekäänud. Neid üles kirjutades hoiame alles seda, mida ei saa millegagi asendada.
Viiendaks. Paigaldage ersa klaviatuuripaigutused ja kasutage neid iga päev, kodus ja koolis. Kirjutage lastele ja sõpradele ersa keeles. Rääkige arendajatele, mis teid takistab, mis on puudu ja mis õnnestus.
Räägi ersa keeles — ja su mõttelaad tugevneb. Ja ka ASR läheb paremaks. Uued algoritmid koguvad ja õpivad seda, mis kuskil koguneb.
Ersa keele digitaalne ellujäämine ei kuulu üksnes ülikoolide laboritele Helsingis või Saranskis. See kuulub igale kõnelejale, kes täna otsustab oma keelt rääkida, kirjutada, lugeda ja salvestada.
Mis on ersa keele jaoks juba praegu olemas Klaviatuur. Rakendus Divvun Keyboards Google Plays ja App Store’is — selles on ersa paigutus. Windowsi ja Maci jaoks — programm Divvun Manager, borealium.org/nb/resource/divvun-manager/. Paigutuses on vanade tekstide märgid: ѣ, ҥ, џ, ѕ, ѵ, ѷ, є, ӓ, ў. Paigutus on kirillitsas; ersa ladina kirja paigutust Divvunil ei ole. Ladina paigutus. Meie paigutus ersa ladina kirja jaoks: valks.erzja.info/ru/raskladki — Windowsile, macOS-ile ja Linuxile; telefonides (Android ja iOS) töötab see tasuta rakenduse Keyman kaudu. Õigekirjakontroll. Androidi paigutusse on see sisse ehitatud, kuid veel viimistlemata. Võrgus — divvun.uit.no, keelte loendis „Эрзянь кель“; versioon on veel arendajatele. Salvesta oma hääl. commonvoice.mozilla.org/myv/speak — lauseid ette lugeda; commonvoice.mozilla.org/myv/listen — teiste salvestusi kontrollida. 8. novembri 2026 seisuga on salvestatud 3,9 tundi ersakeelset kõnet kolmeteistkümnelt inimeselt, kontrollitud 3,8 tundi, lugemiseks on ette valmistatud 5015 lauset. Sõnaraamatud. Meie vene-ersa sõnaraamat Valks: valks.erzja.info — 8. novembri 2026 seisuga 25 057 sõnaartiklit, neist 15 301 kuuluvad tänapäeva sõnaraamatusse, mida peab meie meeskond, ja 9756 Heikki Paasoneni sõnaraamatu digiteeritud murdekihti. Keelekandjad on sisse lugenud 10 196 sõna. Kaartidel on 521 keelekandjate kontrollitud näidet ja üle 16 tuhande näite Paasoneni sõnaraamatust. Otsing tunneb ära 10 439 sõna vormid: kokku umbes 254 tuhat vormi, mida genereerib morfoloogiline analüsaator. On 125 fraasiga vestmik, 24 õppetunniga iseõpik, 207 väljaandega raamatukogu ning vene-, inglise- ja saksakeelne kasutajaliides. GiellaLT projekti sõnaraamat Valks, mis analüüsib iga sõnavormi: valks.oahpa.no — platvorm Neahttadigisánit, ersa keel paaris vene, inglise, saksa, soome, eesti, prantsuse ja mokša keelega. Sõnaraamatute toimetamise platvorm: akusanat.com/verdd — Verdd, Rueteri enda platvorm; selles on 56 keelt, ersa keel koodiga myv. Korpused. Soome Keelepank: kielipankki.fi/korp/. Ersa keele korpused: erzya.web-corpora.net — põhikorpus (2,3 miljonit sõna: ajakirjandus, proosa, blogid) ja sotsiaalmeedia korpus (830 tuhat sõna); tekstid kuni 2018. aasta juulini. Digiteeritud raamatud. Soome Rahvusraamatukogu kogu Fenno-Ugrica: fennougrica.kansalliskirjasto.fi — digiteeritud raamatud, sealhulgas 1930. ja 1940. aastatest. Ersakeelne Vikipeedia: myv.wikipedia.org. 8. novembri 2026 seisuga 7878 artiklit ja 15 aktiivset osalejat viimase kuu jooksul.